NPU, CPU, GPU — und warum Ihre IT keine Garage voller Autos braucht
Jede neue Chip-Generation stellt der IT dieselbe Frage in neuem Gewand: Kaufen wir jetzt allen das neue Auto? Die Klartext-Antwort kommt diesmal nicht aus dem Rechenzentrum, sondern vom Parkplatz — mit einer Garage, einem Anhänger und der Frage, warum Carsharing das bessere Betriebsmodell für den Digital Workplace beschreibt als jeder Beschaffungskatalog.
Drei Rechenwerke, drei Fahrzeugtypen
Bevor die Garage aufgeht, kurz die Fahrzeugkunde. In jedem modernen Rechner arbeiten bis zu drei sehr unterschiedliche „Antriebe“ — und wer sie verwechselt, kauft am Ende das falsche Auto.
Die CPU ist die Alltags-Limousine. Wenige, aber starke Kerne, die alles fahren können: Betriebssystem, Anwendungen, Logik, Datenbanken. Komfortabel, universell, für den einen Fahrer gebaut — aber niemand transportiert mit ihr eine ganze Spedition. Typische Modelle: Intel Core Ultra, AMD Ryzen, Qualcomm Snapdragon X im Client; Xeon, EPYC und Azure Cobalt im Rechenzentrum.
Die GPU ist der komplette Autotransporter-Konvoi. Tausende einfache Kerne, die alle gleichzeitig dieselbe Strecke fahren. Genau dieses Muster — dieselbe Rechenoperation massiv parallel — ist der Grund, warum große Sprachmodelle wie GPT, Claude oder die Modelle in Azure AI Foundry auf GPU-Clustern (NVIDIA H100/B200, AMD Instinct) im Rechenzentrum trainiert und betrieben werden. Ein Konvoi gehört auf die Autobahn, nicht in die heimische Garage: laut, durstig, teuer — aber durch nichts zu ersetzen, wenn Masse bewegt werden muss.
Die NPU ist das hochspezialisierte Effizienz-Fahrzeug. Eine fest verdrahtete Recheneinheit nur für neuronale Netze, gemessen in TOPS (Billionen Operationen pro Sekunde). Sie kann kein Betriebssystem fahren und keine 3D-Szene rendern — dafür erledigt sie kleine KI-Modelle mit einem Bruchteil des Energieverbrauchs. Microsofts Copilot+-Standard verlangt mehr als 40 TOPS. Die aktuelle Generation liegt deutlich darüber: Snapdragon X2 Elite bei 80, AMD Ryzen AI 400 bei bis zu 60, Intel „Panther Lake“ bei bis zu 50 — die Vorgänger mit 45 bis 50 genügen ebenfalls. Es sind Herstellerangaben nach unterschiedlichen Zählweisen; wichtig ist die Klasse, nicht die Nachkommastelle. Darauf laufen lokale Funktionen wie Windows Recall, Click to Do, Live-Übersetzung und kleine Sprachmodelle wie Phi Silica — nicht die großen Modelle aus der Cloud.
| Rechenwerk | Im Autobild | Einsatzzweck | Typische Modelle |
|---|---|---|---|
| CPU | Alltags-Limousine — kann alles, eine Spur | OS, Apps, Logik, Orchestrierung | Core Ultra · Ryzen · Snapdragon X · Xeon · EPYC |
| GPU | Autotransporter-Konvoi — massiv parallel | LLM-Training & -Inferenz, Rendering, Simulation | NVIDIA H100/B200 · AMD Instinct · Azure ND/NC |
| NPU | Effizienz-Spezialist — eine Aufgabe, perfekt | Lokale KI: SLMs, Recall, Übersetzung, Effekte | Copilot+ (40+ TOPS): Snapdragon X2 · Panther Lake · Ryzen AI 400 |
Merksatz für alles Weitere: NPU und Cloud-GPU sind keine Konkurrenten, sondern verschiedene Fahrzeugklassen. Die NPU fährt kleine Modelle lokal und sparsam, der GPU-Konvoi zieht die Frontier-Modelle im Rechenzentrum. Die eigentliche Frage lautet nie „welcher Chip ist besser“, sondern: Welche Fahrt steht an — und welches Fahrzeug holt man sich dafür?
Die Garage, der Anhänger — und der Denkfehler dahinter
Stellen Sie sich jemanden vor, der genug Geld hat, um sich für jeden Zweck das perfekte Auto in die Garage zu stellen. Für die sportliche Fahrt den AMG C63 oder M3/M4. Fürs Gelände den Toyota Land Cruiser. Für die Rennstrecke den Ferrari. Für die Stadt den kleinen, wendigen Smart. Jede Fahrt beginnt mit einem Griff zum passenden Schlüsselbrett — solange immer nur eine Art von Fahrt ansteht.
Das BildDie Garage — und die Alternative daneben
Links steht, was man besitzt: für jeden Zweck ein eigenes Fahrzeug. Rechts steht, was man abrufen kann, wenn man es braucht.
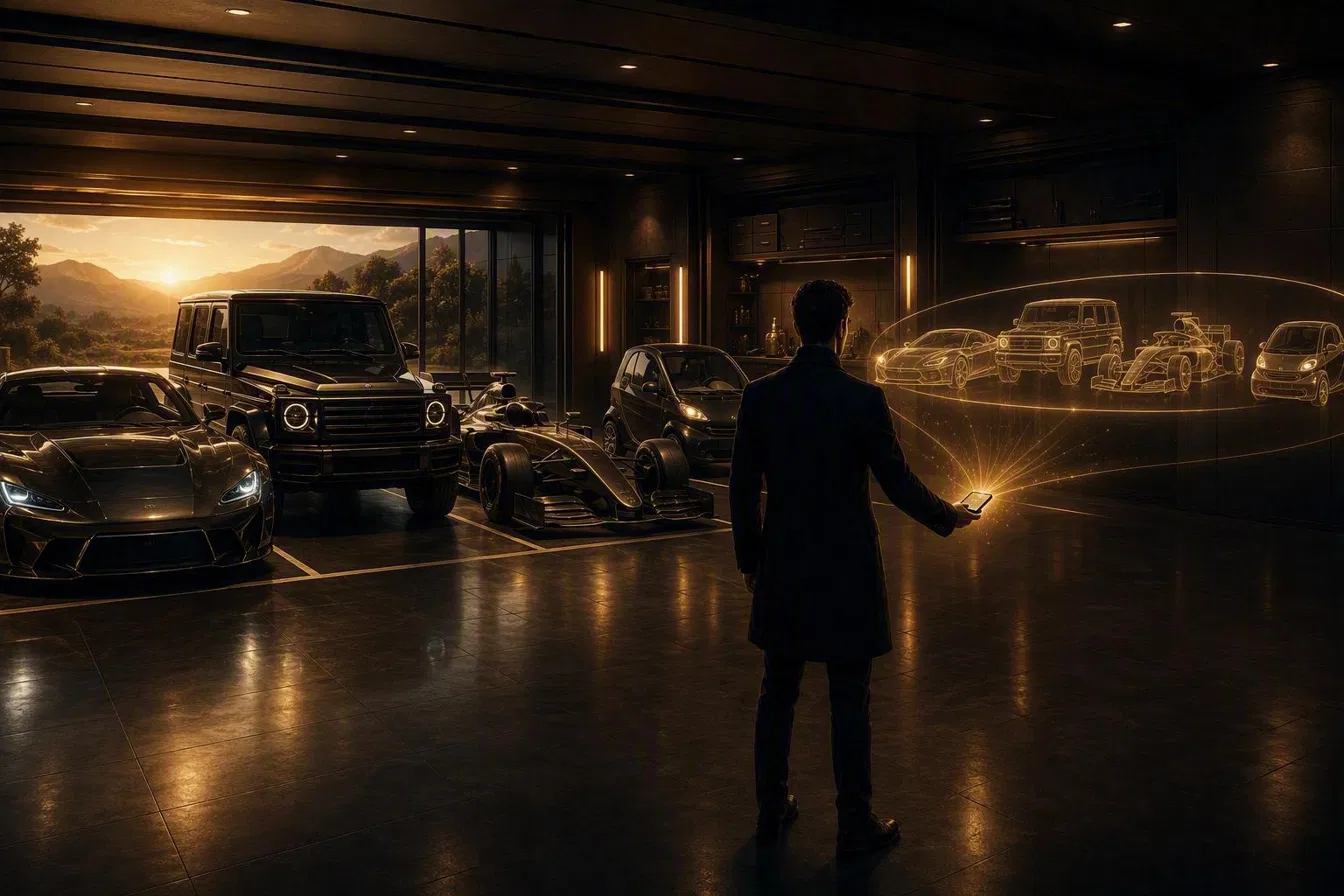
Aber was, wenn der Tag anders aussieht? Morgens ins Gelände. Danach in die Stadt. Abends mit Freunden auf den Nürburgring. Die Antwort der alten Schule kennt jeder, der schon einmal mit Schraubern diskutiert hat: „Nimm halt den Anhänger und beide Autos mit.“ Charmant — und genau der Moment, in dem das Modell kippt: Der Aufwand, die richtige Hardware zur richtigen Fahrt zu schleppen, frisst den Vorteil der Spezialisierung auf.
Jede dieser Maschinen ist für ihren Zweck die richtige. Das Problem ist nicht das einzelne Gerät — es ist das Betriebsmodell dahinter: Für jede neue Anforderungsart wird ein neues Fahrzeug gekauft, pro Person, für Jahre, dimensioniert auf den seltensten Spitzenbedarf. Und wenn sich die Anforderungen mitten im Lebenszyklus ändern — und bei KI ändern sie sich derzeit im Quartalsrhythmus — steht der Anhänger wieder bereit: Zweitgerät, Drittgerät, Sonderbeschaffung.
Der Verkehr hat dieses Problem längst anders gelöst: Carsharing. Das eigene Alltagsfahrzeug für die tägliche Strecke — und für die Ausnahme wird das passende Fahrzeug gemietet, exakt für die Stunden, in denen man es braucht. Niemand kauft einen Transporter, weil zweimal im Jahr ein Umzug ansteht.
Die TOGAF-Frage: Braucht jetzt jeder das NPU-Auto?
Mit Copilot+ liegt die Versuchung wieder auf dem Tisch: Die neue Fähigkeit steckt im Gerät — also tauschen wir die Flotte. Und ehrlicherweise: Diese Fahrt machen wir schon zum dritten Mal. Beim Wechsel von XP auf Windows 7 verlangte das neue System schlicht mehr Hubraum — mehr Arbeitsspeicher der neuen DDR-Generation, 64-Bit-Plattformen; wer nicht aufrüstete, blieb stehen. Beim Sprung auf Windows 10/11 kam die Zulassungsprüfung: TPM 2.0 und Secure Boot als harte Bedingung — funktionierende Geräte verloren ihre Plakette, weil ein Chip fehlte. Und heute klebt die Copilot-Taste auf der Tastatur als sichtbares Zeichen der dritten Welle — dahinter die NPU als neues Eintritts-Kriterium. Zweimal war der Zwang kaum verhandelbar. Beim dritten Mal darf man fragen, ob wirklich wieder die ganze Flotte in die Werkstatt muss.
TOGAF hält dazu eine unbequem einfache Regel bereit: Im ADM-Zyklus kommt die Technologiearchitektur (Phase D) nach der Geschäfts- und Informationssystem-Architektur (Phasen B und C). Erst die Fähigkeit, dann die Anwendung, dann die Technologie. Wer mit der Hardware anfängt, kauft eine Antwort, bevor die Frage formuliert ist — oder im Autobild: Er bestellt den Ferrari, bevor er weiß, ob überhaupt jemand auf die Rennstrecke will.
- Capability statt Katalog: „Mitarbeitende können KI-gestützt arbeiten“ ist die geforderte Fähigkeit. Ob sie über eine lokale NPU, einen Cloud PC oder ein Browser-Frontend erfüllt wird, ist eine Lösungsbaustein-Entscheidung — kein Beschaffungsreflex.
- Gap-Analyse ehrlich fahren: Welche Personas nutzen NPU-Funktionen — lokale Inferenz, Offline-KI, On-Device-Datenschutz — wirklich? Für viele Rollen liegt die tatsächliche KI-Last in M365 Copilot, Claude oder Azure AI: also in der Cloud, nicht im Chip unter der Tastatur.
- Lebenszyklen entkoppeln: Endgeräte leben 4–5 Jahre, KI-Anforderungen ändern sich im Quartal. Wer beides hart verschraubt, baut den nächsten Investitionsstau gleich mit ein.
NPUs sind damit nicht unnötig — sie gehören dorthin, wo die Analyse sie hinlegt: zu Personas mit echtem Bedarf an lokaler Inferenz, Offline-Fähigkeit oder Datenverarbeitung, die das Gerät nicht verlassen darf. Für die Breite der Organisation gibt es das Carsharing-Modell — und das wird gerade sehr konkret.
Wenn Agenten mitfahren: das neue Lastprofil
Warum reicht das Alltagsauto plötzlich nicht mehr? Weil sich die Fahrten geändert haben. KI arbeitet 2026 zunehmend parallel zum Menschen — als Agent, der eigenständig Aufgaben abarbeitet, während die Person längst etwas anderes tut. Mit Claude Cowork, Anthropics Desktop-App für agentische Wissensarbeit, delegieren Nutzer ganze Aufgabenpakete — Recherchen, Dokumentenanalysen, Dateiarbeit — an einen Agenten im Hintergrund. ChatGPT bietet mit seinem Agent-Modus dasselbe Muster, Microsoft Copilot bringt Agenten über Copilot Studio und Agent 365 in den M365-Stack, und auf Azure AI Foundry bauen Unternehmen eigene Agenten für ihre Fachprozesse.
Im Autobild: Es fährt nicht mehr nur der Mensch. Neben der eigenen Fahrt sind ständig ein bis zwei weitere Fahrzeuge im Auftrag unterwegs — und die brauchen mal einen Kleinwagen (Dateiablage sortieren), mal den Transporter (500 Seiten analysieren), mal den Konvoi (Bild- und Videomaterial verarbeiten). Für die IT heißt das konkret:
- Parallelität: Ein Mitarbeiter erzeugt zwei bis drei Sessions Last — die eigene Arbeit plus laufende Agenten-Tasks.
- Volatilität: Agenten-Workloads sind stoßweise. Eine Stunde Volllast, dann Stunden Leerlauf — das Gegenteil eines planbaren Pendelverkehrs.
- Wechselnde Anforderungsarten: Heute Speicher und I/O, morgen Compute, übermorgen GPU. Die Leistungsanforderung ist keine Konstante mehr, sondern eine Kurve.
- Governance: Agenten brauchen Identität, Richtlinien und Isolation wie menschliche Nutzer — Entra ID, Intune und Conditional Access werden zur Verkehrsordnung für Software.
Ein fest gekauftes Fahrzeug ist auf genau ein Lastprofil dimensioniert. Diese Arbeitswelt hat keins mehr.
Carsharing statt Anhänger: mieten, was die Fahrt braucht
Damit steht die strategische Weiche. Es gibt zwei Antworten auf die neue KI-Last:
Weg A — die Garage ausbauen: Für jede Anforderungsart das passende Gerät kaufen, pro Person, und bei jeder neuen Anforderungsklasse den nächsten Flotten-Refresh fahren. Das ist das Anhänger-Modell: technisch machbar, wirtschaftlich und organisatorisch immer einen Zyklus zu spät.
Weg B — das Carsharing-Modell: Jede Person bekommt ein festes Fahrzeug für die Hauptzeit der Arbeit — wahlweise als solides Hardware-Endgerät oder direkt als fest zugewiesener virtueller Rechner (Cloud PC oder AVD-Desktop). Für alles, was davon abweicht, wird nicht gekauft, sondern für die benötigte Zeit gemietet: eine GPU-beschleunigte Session für die 3D-Simulation am Dienstag, ein AI-enabled Cloud PC für das neue Copilot-Szenario, eine isolierte Agenten-Umgebung für den Monatsabschluss. Alternativ — etwa für Externe auf Privatgeräten — auch zwei virtuelle Rechner: einer für die tägliche Arbeit, einer für Agenten und Sonderlasten.
Der entscheidende Mechanismus dahinter: Beim virtuellen Rechner lässt sich die Hardware unter dem Arbeitsplatz ändern, ohne den Arbeitsplatz anzufassen. Von 4 auf 8 vCPU, vom Standard- aufs GPU-Sizing, vom klassischen auf den AI-enabled Cloud PC — per Konfiguration in Minuten statt per Beschaffungsprojekt in Monaten. Kommt morgen eine neue KI-Anforderung, wird umgebucht statt neu gekauft. Genau das ist der Unterschied zwischen einem Fuhrpark, den man besitzt, und Mobilität, die man bezieht.
Und ja — es gibt weiterhin gute Gründe für das eigene Spezialfahrzeug: Entwicklung mit lokaler Inferenz, Außendienst ohne verlässliche Konnektivität, Datenschutz-Szenarien mit On-Device-Verarbeitung. Das Carsharing-Modell verbietet den Ferrari nicht. Es verhindert nur, dass die ganze Belegschaft einen bekommt, weil drei Leute Rennstrecke fahren.
Vom Parkplatz auf die Seekarte
Wer die Seekarten-Metapher aus dieser Reihe kennt, kann das Carsharing-Bild direkt einzeichnen. Zwei Strömungen ziehen aktuell in entgegengesetzte Richtungen: Die Küstenströmung „On-Device“ — Chip-Hersteller und Microsoft schieben KI in die Fläche der Endgeräte, mit dem Versprechen von Latenz nahe null und Daten, die das Gerät nie verlassen. Und die Hochseeströmung „Cloud & Agenten“ — die großen Modelle, Agenten-Plattformen und elastische Rechenleistung wachsen im Rechenzentrum schneller, als jede Geräteflotte nachrüsten könnte.
Ein Schiff, das beide Strömungen mit einem einzigen, schwer beladenen Rumpf fahren will, wird in keiner schnell — das ist die Garage auf See. Die seemännische Antwort ist dieselbe wie am Parkplatz: ein wendiges Boot für die Küste, Zugriff auf das große Schiff für die Hochsee. Die Untiefen sind markiert: Hardware-Wetten auf eine einzige Modellgeneration, Lock-in in ein Lastprofil, Flotten-Refreshes, deren Begründung beim Rollout schon veraltet ist. Der Leuchtturm bleibt derselbe wie im Seekarten-Beitrag: Entscheidungen so bauen, dass sie reversibel bleiben.
Wohin die Reise geht: virtuelle Desktops im Agenten-Zeitalter
Die vielleicht wichtigste Entwicklung des Jahres: Der virtuelle Desktop wechselt gerade selbst die Rolle — vom Arbeitsplatz für Menschen zur Ausführungsumgebung für Menschen und Agenten. Vier Wegmarken zeigen die Richtung:
1 · AI-enabled Cloud PCs: Windows 365 bringt Copilot+-artige Funktionen — verbesserte Windows-Suche, Click to Do — in den Cloud PC. Die „NPU“ sitzt dann nicht mehr im Gerät auf dem Schreibtisch, sondern in der Azure-Infrastruktur darunter. Davor kann ein fünf Jahre altes Notebook oder ein Windows 365 Link stehen — die KI-Fähigkeit kommt trotzdem an. Das ist der Carsharing-Gedanke in Reinform: Die Fahrzeugklasse wird gewechselt, ohne dass jemand ein neues Auto kauft.
2 · Windows 365 for Agents: Seit Build 2026 allgemein verfügbar, erhalten KI-Agenten im Rahmen von Agent 365 — Microsofts Steuerungsebene („Control Plane“) für Unternehmens-Agenten — eigene Cloud PCs — vollwertige, isolierte Windows- oder Linux-Umgebungen, in denen sie Anwendungen bedienen, Dateien verarbeiten und mehrstufige Abläufe ausführen, auch in Legacy-Systemen ohne APIs. Gesteuert mit denselben Werkzeugen wie menschliche Nutzer: Entra ID, Intune, Richtlinien. Der Cloud PC wird zur Mietwagenflotte für Software.
3 · Agenten im eigenen Cloud PC: Assistenten wie Microsoft Scout — Microsofts erster „Autopilot“-Agent, Stand September 2026 als experimentelle Preview im Frontier-Programm und noch nicht allgemein verfügbar — zeigen die Richtung: per Teams-Chat vom Smartphone beauftragt, arbeitet der Agent im persönlichen Cloud PC oder Desktop weiter — Datei finden, zusammenfassen, E-Mail-Entwurf vorbereiten. Der virtuelle Desktop fährt weiter, auch wenn niemand am Steuer sitzt — genau das kann ein Endgerät prinzipbedingt nicht.
4 · Die Richtung dahinter: Microsoft formuliert die Strategie inzwischen selbst plattformübergreifend — KI-Workloads sollen auf dem Gerät, in der Cloud oder über beide hinweg laufen können, ohne dass man sich vorab festlegen muss. Genau deshalb ist die Platzierungsfrage wichtiger als die Chip-Frage: Die Zukunft gehört nicht dem einen Ort, sondern der Fähigkeit, den Ort pro Workload zu wählen — und zu wechseln. Wer heute Architektur baut, baut den Umstieg gleich mit ein.
Für AVD gilt dieselbe Logik mit mehr Steuerungstiefe: GPU-Sizings gezielt den Personas zuordnen, die sie brauchen, Agenten-Workloads in eigene Hostpools isolieren, Kapazität per Autoscaling der tatsächlichen Kurve folgen lassen — statt der ganzen Flotte das teuerste gemeinsame Vielfache zu verordnen.
Das Fazit — ohne Umwege
Kaufen Sie das Fahrzeug für die Hauptstrecke. Mieten Sie den Rest.
Erstens: CPU, GPU und NPU sind Fahrzeugklassen, keine Konkurrenten — Limousine, Konvoi, Effizienz-Spezialist. Die Frage ist immer die Fahrt, nie der Chip.
Zweitens: Nach TOGAF-Logik ist der flächendeckende NPU-Rollout eine Phase-D-Entscheidung — sie fällt nach der Capability- und Gap-Analyse, nicht im Beschaffungskatalog.
Drittens: Agentisches Arbeiten mit Claude Cowork, ChatGPT, Copilot und Azure AI macht Lastprofile parallel, stoßweise und wandelbar — das Gegenteil dessen, wofür man Hardware fest kauft.
Viertens: Das Carsharing-Modell ist die robusteste Antwort: ein festes Fahrzeug für die Hauptzeit — Hardware oder virtuell — und für alles andere die passende Leistung mieten, solange sie gebraucht wird. Ändert sich die Anforderung, wird die Hardware unter dem virtuellen Rechner umgebucht statt die Garage erweitert.
Was die beiden Betriebsmodelle über den Lebenszyklus wirklich kosten, gehört in eine ehrliche TCO-Betrachtung — vom Gerätepreis über Auslastung bis zu Refresh-Zyklen. Und wer sehen möchte, welche der sechs DaaS-Plattformen welches Sizing-, Sharing- und Agenten-Szenario heute abdeckt: Die DaaS Maps stellen über 270 Funktionen herstellerneutral gegenüber.