NPU vs. Cloud: Wo verarbeitet KI künftig Ihre Daten?
Copilot+ PCs verlangen dedizierte KI-Hardware im Endgerät. Gleichzeitig wandern Agenten wie Windows 365 for Agents komplett in die Cloud. Zwei Bewegungen in entgegengesetzte Richtungen — und mittendrin die Frage, die jede Workplace-Strategie beantworten muss: Folgt die Hardware der Architektur, oder diktiert sie sie?
CPU, GPU, NPU — drei Rechenwerke, drei Aufgaben
Bevor über Strategie gesprochen werden kann, muss klar sein, worüber eigentlich entschieden wird. Alle drei Bausteine rechnen — aber sie rechnen fundamental unterschiedlich, und genau daraus ergeben sich ihre Einsatzzwecke.
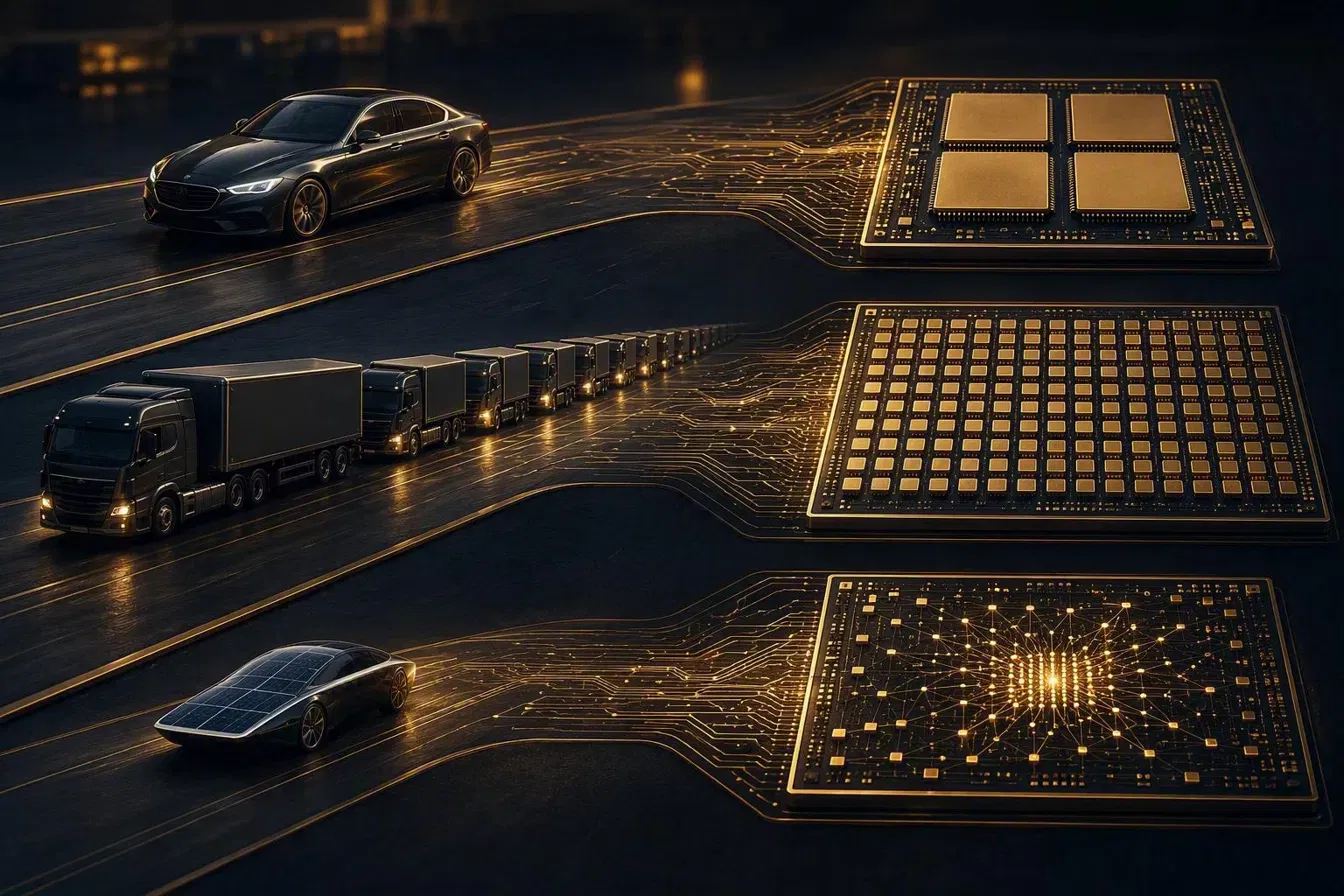
Das BildDrei Fahrzeugklassen, drei Rechenwerke
Bevor es in die Einzelheiten geht, das Bild dazu: Jede Fahrzeugklasse steht für eine Art zu rechnen — und jede führt zu einem anderen Chip.
CPU — der Generalist
Die CPU besteht aus wenigen, aber sehr leistungsfähigen Kernen, die für sequenzielle Logik optimiert sind: Betriebssystem, Anwendungscode, Datenbankabfragen, Verzweigungen, Ein-/Ausgabe. Sie kann alles — nur nichts davon massiv parallel. Typische Vertreter im Client: Intel Core Ultra, AMD Ryzen, Qualcomm Snapdragon X; im Rechenzentrum: Intel Xeon, AMD EPYC, Azure Cobalt (ARM).
GPU — der Parallelrechner
Die GPU bringt tausende einfache Kerne mit, die dieselbe Operation gleichzeitig auf riesigen Datenmengen ausführen. Ursprünglich für Grafik gebaut, ist genau dieses Muster — Matrixmultiplikation in großer Breite — die Grundlage für das Training und die Inferenz großer Sprachmodelle. Deshalb laufen LLMs wie GPT, Claude oder die Modelle in Azure AI Foundry auf GPU-Clustern (NVIDIA H100/B200, AMD Instinct) im Rechenzentrum, nicht auf dem Laptop.
NPU — der Spezialist für KI-Inferenz
Die NPU (Neural Processing Unit) ist eine fest verdrahtete Recheneinheit ausschließlich für neuronale Netze — gemessen in TOPS (Trillionen Operationen pro Sekunde). Sie kann kein Betriebssystem betreiben und keine 3D-Szene rendern. Dafür führt sie kleine, quantisierte KI-Modelle mit einem Bruchteil des Energieverbrauchs einer GPU aus. Microsofts Copilot+-Spezifikation setzt die Messlatte bei mindestens 40 TOPS — erfüllt von allen aktuellen Plattformen: Qualcomm Snapdragon X2 Elite mit 80 TOPS, AMD Ryzen AI 400 „Gorgon Point“ mit bis zu 60 TOPS und Intel Core Ultra Series 3 „Panther Lake“ mit bis zu 50 TOPS, das seit Januar 2026 Lunar Lake als Mainstream-Basis abgelöst hat. Die Vorgängergeneration — Snapdragon X mit rund 45, Lunar Lake mit rund 48, Ryzen AI 300 mit rund 50 TOPS — erfüllt die Schwelle ebenfalls. Sämtliche Werte sind Herstellerangaben nach unterschiedlichen Zählweisen: Intel gibt ausdrücklich INT8 an, Qualcomm nennt keine Präzision. Darauf laufen lokale Funktionen wie Windows Recall, Click to Do, Live-Übersetzung, Studio-Effekte und kleine Sprachmodelle (SLMs) wie Phi Silica.
Die entscheidende Erkenntnis: NPU und Cloud-GPU konkurrieren nicht — sie bedienen unterschiedliche Modellklassen. Auf einer 40-TOPS-NPU laufen kleine Sprachmodelle mit wenigen Milliarden Parametern. Die Frontier-Modelle hinter Copilot, Claude oder ChatGPT liegen um Größenordnungen darüber und bleiben auf absehbare Zeit im Rechenzentrum. Die Frage ist also nicht „NPU oder Cloud“, sondern: welcher Workload läuft wo — und wer bezahlt die Hardware dafür?
Die TOGAF-Frage: Braucht wieder jeder Rechner die Hardware?
Mit Copilot+ steht eine vertraute Versuchung wieder im Raum: Die neue Fähigkeit steckt im Gerät — also tauschen wir die Geräte. Genau an dieser Stelle lohnt der Blick auf das, was TOGAF im ADM-Zyklus konsequent einfordert: Die Technologiearchitektur (Phase D) kommt zuletzt. Zuerst stehen Geschäftsarchitektur (Phase B) und Informationssystem-Architektur (Phase C) — also die Fragen: Welche Fähigkeit braucht das Unternehmen? Welche Anwendungen und Daten liefern sie? Und erst dann: Auf welcher Technologie läuft das?
Wer die Reihenfolge umdreht und mit der Hardware beginnt, kauft eine Antwort, bevor die Frage formuliert ist. Und dieses Muster kennt jede IT-Abteilung — es ist bereits die dritte Welle, in der ein Betriebssystem-Wechsel der Hardware die Bedingungen diktiert:
- XP → Windows 7: Der Sprung verlangte schlicht mehr — mehr Arbeitsspeicher in der neuen DDR-Generation, 64-Bit-taugliche Plattformen. Wer die Flotte nicht aufrüstete, blieb zurück.
- Windows 7 → Windows 10/11: Spätestens Windows 11 zog mit TPM 2.0 und Secure Boot eine harte Sicherheits-Grenze ein — funktionsfähige Geräte fielen aus dem Support, weil ihnen ein Chip fehlte.
- Heute: Die Copilot-Taste auf der Tastatur ist das sichtbare Symbol der dritten Welle — dahinter steht die NPU als neues Eintritts-Kriterium (Copilot+, 40+ TOPS).
Zweimal war der erzwungene Wechsel sicherheits- oder plattformseitig kaum verhandelbar. Beim dritten Mal lohnt die Frage, ob die Fähigkeit wirklich wieder in jedem Gehäuse stecken muss — oder ob die Architektur diesmal eine elegantere Antwort hat.
- Fähigkeit statt Feature: „Mitarbeitende können KI-gestützt arbeiten“ ist die Capability. Ob sie über eine lokale NPU, einen Cloud PC oder ein Browser-Frontend erfüllt wird, ist eine Lösungsbaustein-Entscheidung — kein Vorab-Beschluss.
- Gap-Analyse ehrlich rechnen: Welche Personas nutzen NPU-Funktionen wie lokale Inferenz, Offline-KI oder Datenschutz-kritische Verarbeitung tatsächlich? Für viele Rollen ist die ehrliche Antwort: kaum — ihre KI-Last liegt in M365 Copilot, Claude oder Azure AI, also in der Cloud.
- Lebenszyklen entkoppeln: Endgeräte leben 4–5 Jahre, KI-Anforderungen ändern sich derzeit im Quartalsrhythmus. Eine Architektur, die beide Zyklen hart aneinander koppelt, baut sich ihren nächsten Investitionsstau selbst.
Das heißt nicht, dass NPUs unnötig sind. Es heißt: Sie gehören dorthin, wo die Capability-Analyse sie hinlegt — zu Personas mit echtem Bedarf an lokaler Inferenz, Offline-Fähigkeit oder On-Device-Datenschutz. Für alle anderen gibt es einen zweiten Weg, und der wird gerade sehr konkret.
Wenn Agenten mitarbeiten, ändert sich das Lastprofil
Die Diskussion um KI-Hardware wird oft geführt, als ginge es weiter um einen Chatbot im Browser-Tab. Die Realität in Unternehmen sieht 2026 anders aus: KI arbeitet zunehmend parallel zum Menschen — als Agent, der eigenständig Aufgaben abarbeitet, während die Person etwas anderes tut.
Konkrete Beispiele aus dem Alltag: Mit Claude Cowork, Anthropics Desktop-App für agentische Wissensarbeit, delegieren Nutzer ganze Aufgabenpakete — Recherchen, Dokumentenanalysen, Dateiarbeit — an einen Agenten, der sie im Hintergrund abarbeitet. ChatGPT bietet mit seinem Agent-Modus ein vergleichbares Muster, Microsoft Copilot bringt Agenten über Copilot Studio und Agent 365 direkt in den M365-Stack, und auf Azure AI Foundry bauen Unternehmen eigene Agenten für ihre Fachprozesse. Vier Ökosysteme, ein gemeinsamer Effekt auf die IT:
- Parallelität: Ein Mitarbeiter erzeugt nicht mehr eine Session Last, sondern zwei bis drei — die eigene Arbeit plus laufende Agenten-Tasks.
- Volatilität: Agenten-Workloads sind stoßweise. Eine Stunde Dokumentenanalyse mit voller Last, dann Stunden fast nichts. Klassische Client-Dimensionierung („ein Profil für alle“) passt auf dieses Muster nicht.
- Wechselnde Anforderungen: Heute braucht der Agent vor allem Speicher und I/O (Dateiarbeit), morgen Compute (Analyse), übermorgen eine GPU (Bild-/Videoverarbeitung). Die Leistungsanforderung ist keine Konstante mehr, sondern eine Kurve.
- Governance: Agenten brauchen Identität, Richtlinien und Isolation wie menschliche Nutzer — Entra ID, Intune und Conditional Access werden zur Agenten-Infrastruktur.
Ein Endgerät ist in genau einer Dimension unschlagbar: Es ist da, wo der Mensch ist. In allen anderen Dimensionen — elastisch skalieren, Lastspitzen abfedern, Profile pro Rolle differenzieren, Agenten isolieren — ist fest verbaute Hardware die unflexibelste Antwort, die die IT geben kann.
Ein Rechner für alles — oder entkoppeln?
Damit steht die eigentliche strategische Weiche fest. Es gibt zwei Antworten auf die neue KI-Last:
Weg A — alles in ein Gerät: Flächendeckend Copilot+-Hardware beschaffen und hoffen, dass die heute gekaufte NPU-Klasse die KI-Anforderungen der nächsten vier bis fünf Jahre trägt. Jede neue Anforderungsklasse, die die verbaute Hardware übersteigt, löst den nächsten Refresh aus — für die gesamte Flotte, unabhängig davon, wer die Leistung wirklich braucht.
Weg B — Mensch und Rechenleistung entkoppeln: Jede Person erhält ein schlankes Endgerät als Zugangspunkt (Notebook, Thin Client oder ein Purpose-Built-Gerät wie Windows 365 Link) plus einen virtuellen Rechner — einen Cloud PC oder AVD-Desktop. Alternativ, etwa für externe Mitarbeitende auf Privatgeräten, auch zwei virtuelle Rechner: einer für die tägliche Arbeit, einer als isolierte Umgebung für Agenten oder Sonderlasten. Der entscheidende Unterschied: Wenn morgen eine neue KI-Anforderung kommt, wird die Hardware unter dem virtuellen Rechner angepasst — per Resize im Portal statt per Beschaffungsprojekt. Von 4 vCPU auf 8, von Standard- auf GPU-beschleunigtes Sizing, von einem klassischen Cloud PC auf einen AI-enabled Cloud PC — ohne dass ein einziges Gerät den Schreibtisch verlässt.
Weg B ist kein Plädoyer gegen Endgeräte — es wird weiterhin Personas geben, für die ein Copilot+-Gerät die richtige Antwort ist: Entwicklerinnen mit lokaler Inferenz, Außendienst ohne verlässliche Konnektivität, Datenschutz-Szenarien mit On-Device-Verarbeitung. Der Punkt ist ein anderer: Die Standardantwort für die Breite der Organisation sollte die flexible sein, nicht die festverbaute. Genau das ist Total Cost of Ownership über den Lebenszyklus gedacht — nicht der Gerätepreis am Beschaffungstag.
Navigation statt Nachrüstung: das Bild zur Vision
Wer die Seekarten-Metapher aus dem gleichnamigen Beitrag dieser Reihe kennt, kann die NPU-Frage darin präzise verorten. Die Strömungen auf der Karte sind die Kräfte, die man nicht kontrolliert, aber lesen muss — und aktuell ziehen zwei davon in entgegengesetzte Richtungen:
- Die Küstenströmung „On-Device“: Chip-Hersteller und Microsoft schieben KI in die Fläche der Endgeräte — Copilot+, NPUs, lokale SLMs. Sie verspricht Latenz nahe null und Daten, die das Gerät nie verlassen.
- Die Hochseeströmung „Cloud & Agenten“: Die großen Modelle, die Agenten-Plattformen und die elastische Rechenleistung liegen im Rechenzentrum — und wachsen dort schneller, als jede Geräteflotte nachrüsten könnte.
Ein Schiff, das versucht, beide Strömungen gleichzeitig mit einem einzigen, schwer beladenen Rumpf zu fahren, wird in keiner davon schnell. Die seemännische Antwort ist eine andere: ein wendiges Boot für die Küste — das Endgerät — und Zugriff auf das große Schiff auf hoher See — den virtuellen Rechner. Die Untiefen auf dieser Route sind bekannt: Hardware-Investitionen, die auf eine einzige Modellgeneration wetten. Lock-in in ein Lastprofil. Und Flotten-Refreshes, deren Begründung schon beim Rollout veraltet ist. Der Leuchtturm, an dem sich der Kurs ausrichtet, ist derselbe wie im Seekarten-Beitrag: Entscheidungen so bauen, dass sie reversibel bleiben.
Was das für virtuelle Desktops bedeutet — und was Agentic AI daraus macht
Die spannendste Entwicklung des Jahres ist, dass der virtuelle Desktop selbst gerade seine Rolle wechselt: vom Arbeitsplatz für Menschen zur Ausführungsumgebung für Menschen und Agenten. Drei Bausteine zeigen, wohin die Reise geht:
1 · AI-enabled Cloud PCs: Windows 365 bringt Copilot+-artige Funktionen — verbesserte Windows-Suche, Click to Do — in den Cloud PC. Die „NPU“ sitzt dann nicht mehr im Gerät auf dem Schreibtisch, sondern in der Azure-Infrastruktur darunter. Das Endgerät davor kann ein fünf Jahre alter Laptop oder ein Windows 365 Link sein — die KI-Fähigkeit kommt trotzdem an.
2 · Windows 365 for Agents: Seit Build 2026 allgemein verfügbar, bekommen KI-Agenten im Rahmen von Agent 365 — Microsofts Steuerungsebene („Control Plane“) für Unternehmens-Agenten — eigene Cloud PCs — vollwertige, isolierte Windows- (oder Linux-)Umgebungen, in denen sie Anwendungen öffnen, Dateien verarbeiten und mehrstufige Abläufe ausführen, auch in Legacy-Systemen ohne APIs. Gesteuert mit denselben Werkzeugen wie menschliche Nutzer: Entra ID, Intune, Richtlinien. Der Cloud PC wird damit zur „Persona“ für Software.
3 · Agenten im eigenen Cloud PC: Parallel entstehen Assistenten wie Microsoft Scout, Microsofts erster „Autopilot“-Agent — Stand September 2026 als experimentelle Preview im Frontier-Programm, noch nicht allgemein verfügbar. Die Richtung ist trotzdem klar erkennbar: per Teams-Chat vom Smartphone beauftragt, arbeitet der Agent im persönlichen Cloud PC oder Desktop weiter — Datei finden, zusammenfassen, E-Mail-Entwurf vorbereiten — auch bei zugeklapptem Laptop. Der virtuelle Desktop läuft weiter, auch wenn kein Mensch davorsitzt — und genau das können Endgeräte prinzipbedingt nicht leisten.
Für AVD gilt dieselbe Logik mit anderem Steuerungsgrad: Wer Hostpools betreibt, kann GPU-beschleunigte Sizings gezielt den Personas zuordnen, die sie brauchen, Agenten-Workloads in eigene Pools isolieren und Kapazität per Autoscaling der tatsächlichen Kurve folgen lassen — statt der Flotte das teuerste gemeinsame Vielfache zu verordnen.
Das Fazit in vier Sätzen
NPU vs. Cloud ist die falsche Rivalität.
Erstens: NPU und Cloud-GPU bedienen unterschiedliche Modellklassen — kleine lokale Inferenz hier, Frontier-Modelle und Agenten dort. Die Frage ist Workload-Platzierung, nicht Lagerzugehörigkeit.
Zweitens: Nach TOGAF-Logik ist ein flächendeckender NPU-Rollout eine Phase-D-Entscheidung, die erst nach ehrlicher Capability- und Gap-Analyse fallen darf — nicht davor.
Drittens: Agentisches Arbeiten mit Claude Cowork, ChatGPT, Copilot und Azure AI macht Lastprofile parallel, volatil und wechselhaft — das Gegenteil dessen, wofür fest verbaute Hardware gut ist.
Viertens: Die robusteste Antwort für die Breite ist die Entkopplung: schlankes Endgerät plus virtueller Rechner (oder zwei) — und wenn neue KI-Anforderungen kommen, wird die Hardware darunter angepasst statt neu gekauft.
Wie sich diese Platzierungsentscheidung in konkreten Zahlen niederschlägt, ist Gegenstand der TCO-Betrachtung dieser Reihe. Und wer die sechs DaaS-Plattformen im Detail vergleichen möchte, findet in den DaaS Maps über 270 Funktionen gegenübergestellt.